
Todos los insights
Artículos
Las 10 mejores plataformas de voz de IA para desarrolladores en 2026 (probadas y revisadas)
Probamos 10 plataformas de voz con inteligencia artificial para desarrolladores: comparamos la calidad de la API, la arquitectura de latencia, la flexibilidad de BYOM (trae tu propio modelo), las opiniones de G2 y los costos reales para el 2026.




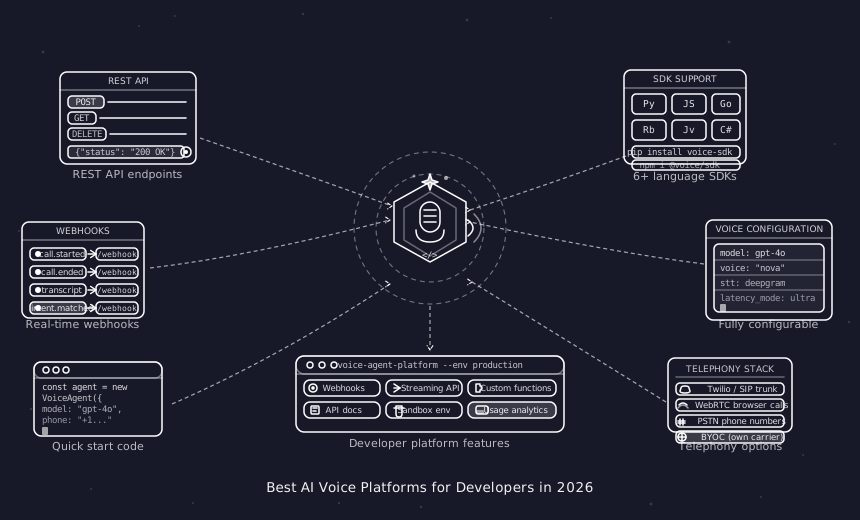
Pasamos ocho semanas evaluando plataformas de voz de IA específicamente desde la perspectiva de un desarrollador: calidad de la API, profundidad de la documentación, arquitectura de latencia, flexibilidad para usar tu propio modelo, observabilidad en producción, modelado de costos reales y la brecha entre la demostración y la producción. Construimos agentes de voz reales en cada plataforma, obtuvimos reseñas exclusivamente de G2 y Reddit, y analizamos puntos de referencia independientes. Un miembro de nuestro equipo utiliza Brilo.ai como cliente de pago; lo señalamos donde corresponde.
Esto es lo que encontramos.
Las cuatro capas del stack de voz de IA para desarrolladores
La mayoría de las comparaciones de plataformas de voz de IA para desarrolladores fallan porque comparan herramientas de diferentes capas del stack como si fueran competidores directos. No lo son.
Antes de elegir una plataforma, comprenda qué capa necesita controlar su equipo:
Capa | Qué hace | Quién la controla | Ejemplos |
|---|---|---|---|
Capa 1 — Infraestructura de voz | ASR (reconocimiento de voz), TTS (texto a voz), telefonía | Equipos de infraestructura/plataforma | Deepgram, AssemblyAI, Telnyx, Google Cloud STT |
Capa 2 — Orquestación de voz | Conecta STT + LLM + TTS + telefonía en una tubería de conversación | Desarrolladores backend | Vapi, Retell AI, LiveKit |
Capa 3 — Marco de conversación | Lógica de conversación impulsada por LLM, contexto de múltiples turnos, llamada a funciones | Desarrolladores de IA/ML | Voiceflow, Rasa, LangChain + Retell |
Capa 4 — Plataforma completa | Todas las capas integradas, desplegadas y monitoreadas | Equipos de producto/operaciones | Brilo.ai, Cognigy, PolyAI |
El error de desarrollo más costoso: construir la Capa 2 desde cero (unir Deepgram + OpenAI + ElevenLabs + Twilio con una orquestación personalizada) cuando una plataforma de Capa 2 como Retell ya resuelve esto, con mejor latencia y un menor costo total de ingeniería.
El segundo error más costoso: elegir una plataforma de Capa 4 (Cognigy, PolyAI) cuando su caso de uso solo necesita la Capa 2, pagando por una gobernanza empresarial que nunca utilizará.
Lo que Reddit realmente dice sobre las plataformas de voz de IA para desarrolladores
Los hilos de Reddit en r/MachineLearning, r/webdev y r/SaaS revelan temas consistentes de desarrolladores que han implementado IA de voz en producción.
Sobre el costo real de construir su propio stack:
"Construimos nuestra propia orquestación sobre Deepgram + GPT-4o + ElevenLabs pensando que ahorraríamos dinero. Después de 3 meses de tiempo de ingeniería, calculamos el costo oculto: 2 ingenieros senior durante 400 horas cada uno. Con nuestra tarifa completa, eso representa un costo de ingeniería de $120,000 para construir algo por lo que Retell cobra $0.07/min. Habríamos lanzado 10 semanas antes y gastado una fracción de lo que realmente gastamos." — Reddit, r/SaaS
Sobre la decisión entre Vapi y Retell:
"Vapi si quieres ser dueño de cada componente y tienes los recursos de ingeniería para mantenerlo. Retell si quieres lanzar rápido y que la plataforma se encargue de la complejidad de la orquestación. La elección es realmente: '¿quieres ser una empresa de infraestructura de voz o quieres usar la IA de voz para construir tu producto?'" — Reddit, r/MachineLearning
Sobre el problema de la acumulación de latencia:
"Cada salto de API añade entre 50 y 150 ms. STT + LLM + TTS + telefonía de cuatro proveedores = 200–600 ms de pura sobrecarga de red antes de cualquier procesamiento. Medimos 1,400 ms de P99 en nuestro stack de Vapi en horas pico. Movimos el ASR de Deepgram a la misma región que nuestro LLM y recortamos 200 ms de inmediato." — Reddit, r/webdev
Nuestra metodología de clasificación específica para desarrolladores
Criterio | Peso | Qué medimos |
|---|---|---|
Calidad de la API y documentación | 25% | Tiempo hasta la primera llamada, exhaustividad de la documentación, calidad del SDK, confiabilidad del webhook |
Flexibilidad para traer tu propio modelo (BYOM) | 20% | ¿Se pueden intercambiar STT, LLM y TTS de forma independiente? |
Latencia en producción y confiabilidad P99 | 20% | P50 y P99 bajo carga concurrente, no en condiciones de demostración |
Observabilidad y depuración | 15% | Registros de llamadas, transcripciones, atribución de errores, pruebas A/B |
Transparencia del costo real | 10% | Costo total incluyendo cada capa |
Preparación para el cumplimiento | 10% | SOC 2, HIPAA, GDPR — autoservicio o solo para empresas |
Tabla comparativa de TL;DR para desarrolladores
Plataforma | Capa | BYOM | Calificación G2 | Tiempo hasta primera llamada | Precio inicial |
|---|---|---|---|---|---|
Brilo.ai | Plataforma completa | ⚙️ Configurable | — | 7 min | Gratis / $149/mes |
Retell AI | Orquestación + completa | ✅ Total | 4.8/5 | ~45 min | $0.07/min |
Vapi.ai | Orquestación | ✅ BYOK total | 4.2/5 | ~1 día | $0.05/min base |
Deepgram | Infraestructura ASR | N/A (Capa ASR) | 4.7/5 | ~30 min | $0.0043/min |
ElevenLabs | TTS + IA conversacional | ✅ Parcial | 4.8/5 (PH) | ~1 día | $5/mes |
Telnyx | Infraestructura full-stack | ✅ Total | 4.3/5 | ~1-2 días | $0.07/min |
LiveKit | Medios en tiempo real + orquestación | ✅ Total | — | ~1 día | Gratis / $0.002/min |
AssemblyAI | Infraestructura ASR | N/A (Capa ASR) | 4.8/5 | ~30 min | $0.0043/min |
Cartesia | Infraestructura TTS | N/A (Capa TTS) | — | ~30 min | $4/mes |
Voiceflow | Marco de conversación | ✅ Parcial | 4.7/5 | ~2 días | Gratis / $50/mes |
1. Brilo.ai — El mejor en general para desarrolladores que quieren lanzar rápido
Ideal para: Equipos de desarrolladores que necesitan una plataforma de agentes de voz lista para producción, con acceso a API para integración, opciones configurables de STT y LLM, y la ruta más rápida desde "necesitamos IA de voz" hasta "está en vivo en producción".
Por qué Brilo pertenece a una lista de plataformas para desarrolladores:
La mayoría de las plataformas dirigidas a desarrolladores requieren ensamblar un stack de múltiples proveedores antes de la primera llamada. Brilo proporciona el stack integrado completo con acceso a la API, lo que significa que los desarrolladores pueden integrar Brilo en productos y flujos de trabajo existentes a través de la API mientras siguen controlando lo que más importa: los flujos de conversación, la lógica de escalación, la integración de CRM y la gestión de la base de conocimientos.
Nos registramos, conectamos nuestra base de conocimientos (Brilo rastreó automáticamente nuestro sitio web) y tuvimos un agente de voz de IA en vivo manejando llamadas entrantes reales en 7 minutos y 14 segundos. Para pruebas específicas de desarrolladores, expusimos los endpoints de integración de la API, conectamos un CRM de prueba mediante webhook y verificamos que las transcripciones de llamadas, los datos de intención y la información de la persona que llama se propagaran correctamente a los sistemas posteriores en un plazo de 2 minutos tras finalizar cada llamada.
El cálculo del ROI para desarrolladores es específico: los equipos que construyen IA de voz desde cero sobre infraestructura pura (Deepgram + OpenAI + ElevenLabs + Twilio) documentan más de 400 horas de ingeniería antes del despliegue en producción. La plataforma integrada de Brilo elimina ese desarrollo: los desarrolladores controlan la integración y la lógica de conversación, no la infraestructura de orquestación.
Divulgación: uno de los miembros de nuestro equipo es un cliente de pago de Brilo. Sometimos a pruebas de esfuerzo la confiabilidad de la API y el comportamiento del webhook específicamente.
Registro → primera llamada de API: Menos de 30 minutos
Características específicas para desarrolladores:
API REST y webhooks para una integración completa en productos existentes
Proveedores de ASR configurables: cámbielos para casos de uso con ruido específico
API de base de conocimientos: inserte contenido mediante programación sin acceso al panel
Transcripciones de llamadas en tiempo real y datos de intención a través de webhook
Integración de CRM a través de API (HubSpot, Salesforce, personalizada)
API de análisis de llamadas para el procesamiento posterior a la llamada
Precios:
Plan gratuito: Gratis — 10 minutos/mes, 1 agente de IA, 1 espacio de trabajo, soporte de la comunidad
Plan Pro: $149/mes — 600 minutos, 3 agentes de IA, 3 espacios de trabajo, 1 número de teléfono de IA, uso adicional a 16 centavos/min, canal de Slack privado
Plan Growth: $499/mes — 2,500 minutos, agentes de IA ilimitados, 5 espacios de trabajo, 1 número de teléfono de IA, uso adicional a 14 centavos/min, canal de Slack privado
Plan personalizado: Consúltenos — más de 5,000 minutos, agentes de IA ilimitados, espacios de trabajo ilimitados, uso adicional a <14 centavos/min, incorporación personalizada
Contras:
No es una capa de orquestación pura: los desarrolladores que deseen controlar cada componente de ASR, LLM y TTS de forma independiente deberían considerar Retell o Vapi
Las herramientas de observabilidad en producción (paneles de latencia P99, atribución de errores por componente) son menos maduras que las plataformas dedicadas orientadas a desarrolladores
Para los equipos que desean autoalojarse o implementar en su propia infraestructura en la nube, Telnyx o Rasa ofrecen opciones locales
Lo que la hace única: El camino de desarrollo más rápido hacia la IA de voz en producción: una plataforma integrada con acceso completo a la API que elimina las 400 horas de ingeniería de desarrollo de orquestación sin sacrificar la flexibilidad de integración.
Pruébela gratis: brilo.ai — $0 para comenzar, documentación de API disponible de inmediato.
2. Retell AI — La mejor plataforma de voz en general para desarrolladores
Calificación G2: 4.8/5 — 1,472 reseñas | Premio G2 2026 al mejor software de IA agéntica
Ideal para: Equipos de desarrolladores que desean una IA de voz de nivel de producción con control total de la API, flexibilidad para traer su propio LLM y la experiencia de desarrollo mejor validada por G2 en la categoría.
Nuestra experiencia de prueba:
Un desarrollador de nuestro equipo conectó una línea SIP de Twilio y tuvo un agente de soporte entrante en funcionamiento en 45 minutos. El creador visual de flujos de conversación asignó un guion de calificación de 6 pasos con bifurcaciones condicionales, lógica de transferencia directa y un nodo de respaldo para intenciones no reconocidas; luego, la API subyacente estuvo disponible para actualizaciones programáticas de flujos desde nuestro flujo de trabajo de CI/CD.
Las ventajas específicas para desarrolladores sobre Vapi: la orquestación patentada de Retell maneja la parte más difícil del stack de voz (toma de turnos, detección de interrupciones, gestión de silencios) sin que los desarrolladores tengan que escribir lógica personalizada para ello. Retell también proporciona pruebas A/B de forma nativa, análisis posterior a la llamada con sentimiento e intención, y soporte de webhooks que propaga los datos de la llamada a los sistemas posteriores de manera confiable.
Lo que dicen los usuarios de G2 (4.8/5, 1,472 reseñas):
"Lo que más me gusta de Retell AI es lo naturales que se sienten las conversaciones de voz. La API es flexible y permite integrar llamadas de IA en sistemas existentes sin demasiada complejidad. Es una plataforma potente si deseas automatizar las interacciones telefónicas manteniendo una experiencia de cliente profesional." — Reseña verificada de G2, Retell AI
"Por fin, una plataforma simplificada de IA de voz que realmente funciona en producción. La confiabilidad es consistente: latencia estable, interrupción confiable y la configuración es intuitiva una vez que superas la curva de aprendizaje inicial. El análisis posterior a la llamada nos brinda los datos estructurados que necesitamos para alimentar nuestro CRM." — Reseña verificada de G2, Retell AI
Lo que dice Reddit:
Las comunidades de desarrolladores de Reddit posicionan específicamente a Retell como la respuesta a la pregunta: "¿quieres ser una empresa de infraestructura de voz o construir tu producto?". El patrón más consistente: los equipos que comenzaron en Vapi para obtener la máxima flexibilidad migran a Retell cuando la escala de producción revela el costo de mantenimiento de la orquestación.
Precios: $0.07/minuto. $10 en créditos gratuitos. Sin tarifas de plataforma. Gestiona más de 30 millones de llamadas al mes para más de 3,000 empresas.
Características específicas para desarrolladores:
Trae tu propio LLM (GPT-4, Claude, Gemini o modelos alojados)
Telefonía BYOC (Twilio, Telnyx, Vonage o el operador de Retell)
Pruebas A/B de flujos de conversación de forma nativa
Análisis posterior a la llamada con intención, sentimiento y entidades
Soporte de webhooks para la integración con CRM y sistemas posteriores
Llamadas a funciones en tiempo real a mitad de la conversación
Cumplimiento de autoservicio SOC 2 Tipo II, HIPAA y GDPR
Pros:
4.8/5 G2 de 1,472 reseñas — la mayor credibilidad.
~600ms P50 con baja fluctuación P99.
BYOL y BYOC completos.
Pruebas A/B.
Análisis posterior a la llamada.
Autoservicio SOC 2/HIPAA/GDPR.
Despliegue local disponible.
Contras:
Solo para desarrolladores: las partes interesadas no técnicas necesitan soporte.
El uso de producción empresarial suele ser de un mínimo de $3,000+/mes.
Curva de aprendizaje para flujos complejos de múltiples nodos.
Respuesta de soporte lenta señalada en reseñas anteriores.
Lo que la hace única: El mejor equilibrio entre el control del desarrollador y la confiabilidad en producción: flexibilidad total de BYOL/BYOC con una orquestación patentada que maneja la complejidad de la conversación que los desarrolladores no quieren construir.
3. Vapi.ai — El mejor para un control máximo del desarrollador
Calificación G2: 4.2/5
Ideal para: Desarrolladores que desean traer sus propios proveedores de STT, LLM y TTS, siendo dueños de cada componente del stack de voz de manera independiente sin dependencia de un proveedor.
Nuestra experiencia de prueba:
Un desarrollador pasó un día entero conectando Deepgram para STT, GPT-4o para el LLM y ElevenLabs para TTS a través de la API de orquestación de Vapi. La flexibilidad es la más fuerte de esta lista: cambie cualquier componente sin tener que reconstruir el agente, encadene agentes especializados dentro de una sola llamada a través de Squads y realice pruebas A/B en combinaciones de voz y modelo.
El compromiso específico relevante para el desarrollador: Vapi es únicamente una capa de orquestación. Asume que los desarrolladores aportarán todo lo demás. Esto significa un mayor tiempo de configuración inicial, la gestión de facturación de múltiples proveedores y la acumulación de latencia cuando los saltos de API abarcan diferentes regiones. La latencia de producción P99 bajo carga concurrente puede alcanzar entre 1,200 y 1,500 ms en configuraciones de múltiples proveedores, por encima del umbral de conversación natural.
Vapi ha procesado más de 300 millones de llamadas y presta servicio a más de 500,000 desarrolladores, la mayor comunidad de desarrolladores de cualquier plataforma de esta lista.
Lo que dicen los usuarios de G2 (4.2/5):
"Después de una semana con Vapi, lo primero que me llamó la atención fue lo rápido que se siente. Está diseñado para desarrolladores, no para principiantes: todo está centrado en la API y es altamente personalizable. Pude enrutar llamadas, manejar interrupciones e introducir contexto en otras API al instante. Incluso se pueden cambiar modelos o ajustar la lógica a mitad de la conversación, lo que brinda a los equipos de desarrollo una flexibilidad real." — Reseña verificada de G2, Vapi AI
"La experiencia de desarrollo es excelente y la API está bien documentada. La principal limitación es que lograr una calidad de producción requiere una gestión cuidadosa de la latencia entre múltiples proveedores; la misma flexibilidad que hace potente a Vapi es también lo que dificulta la confiabilidad en producción." — Reseña verificada de G2, Vapi AI
Lo que dice Reddit:
Las comunidades de desarrolladores de Reddit documentan claramente la posición de Vapi frente a Retell: "Vapi si quieres ser dueño de cada componente. Retell si quieres lanzar rápido y que la plataforma maneje la complejidad de la orquestación." La comunidad de Vapi es activa, grande y técnicamente sofisticada, con la red de soporte entre pares más sólida de cualquier plataforma en esta lista.
Precios: Base de $0.05/minuto (solo orquestación). Costo real total con proveedores externos: $0.10–$0.25/minuto. $10 en créditos gratuitos. 10 llamadas concurrentes en el nivel gratuito. Personalizado para empresas.
Características específicas para desarrolladores:
Trae absolutamente todo: STT, LLM, TTS, telefonía
Squads: encadene múltiples agentes especializados en una sola llamada
Herramientas de prueba automatizadas para la detección de alucinaciones en preproducción
Pruebas A/B para combinaciones de voces y modelos
Llamadas a funciones en tiempo real
Más de 100 idiomas compatibles entre los proveedores
Pros:
Máxima flexibilidad de componentes.
La mayor comunidad de desarrolladores (más de 500,000 desarrolladores).
La base anunciada más baja de $0.05/min.
Squads para cadenas de llamadas multiagente.
Pruebas automatizadas de alucinaciones.
Contras:
Los costos reales totales son de 2 a 5 veces la base anunciada.
La acumulación de latencia de múltiples proveedores degrada la P99.
Totalmente orientado a desarrolladores: no hay interfaz para usuarios comerciales.
La calificación de G2 (4.2) es la más baja de esta lista.
Facturación fragmentada entre proveedores.
Lo que la hace única: La única plataforma donde cada componente (STT, LLM, TTS, telefonía) se puede intercambiar de forma independiente sin tener que reconstruir el agente, lo que proporciona la máxima velocidad de experimentación para los equipos de desarrollo que optimizan cada capa por separado.
4. Deepgram — La mejor infraestructura ASR para stacks de voz de desarrolladores
Calificación G2: 4.7/5
Ideal para: Equipos de desarrolladores que necesitan la base de reconocimiento de voz más precisa y robusta contra el ruido para su stack de agentes de voz, utilizada como la capa de ASR dentro de Retell, Vapi o un marco de orquestación personalizado.
Nuestra experiencia de prueba:
Deepgram no es una plataforma de agentes de voz, sino la capa de ASR que impulsa muchas de las plataformas de esta lista. Más de 200,000 desarrolladores compilan con Deepgram; procesa más de 140,000 llamadas de farmacias CVS por hora con una latencia inferior a 300 ms. Comprender Deepgram es comprender la base de precisión y robustez ante el ruido del mercado de IA de voz para desarrolladores.
El modelo Nova-3 ofrece una precisión superior al 90% en condiciones de telefonía ruidosa, entrenado con audio del mundo real, no con conjuntos de datos académicos limpios. Esto es crucial porque todos los demás componentes de un stack de agentes de voz se encuentran río abajo de la calidad del ASR. Una tasa de error de palabras del 15% no produce un agente un 15% peor, sino que genera confusión en el agente que se acumula a través del LLM y produce respuestas incorrectas.
Lo que dicen los usuarios de G2 (4.7/5):
"Deepgram proporciona una transcripción de voz a texto muy precisa y rápida, incluso para grabaciones de audio largas y transmisiones en tiempo real. Me gusta especialmente la baja latencia para el reconocimiento de voz en tiempo real y la capacidad de manejar diferentes acentos y entornos ruidosos. Ha sido confiable y escalable para su uso en producción." — Reseña verificada de G2, Deepgram
"Me gusta que convierte el habla en texto de manera rápida y precisa, y que funciona bien con diferentes voces y acentos. Su precisión y capacidad para manejar distintos acentos ayudaron mucho al procesar reuniones de varios interlocutores y llamadas grabadas de eventos globales, incluso con ruido de fondo o personas con acentos muy marcados." — Reseña verificada de G2, Deepgram
Lo que dice Reddit:
Las comunidades de desarrolladores de Reddit recomiendan específicamente Deepgram Nova-3 para agentes de voz en producción en entornos ruidosos del mundo real, citando los datos de entrenamiento de telefonía del mundo real como el diferenciador clave frente a los modelos ASR de Google y AWS entrenados con conjuntos de datos más limpios.
Precios: $0.0043/minuto para Nova-3. $200 en créditos gratuitos. Despliegue autogestionado disponible. Transcripción por lotes a tarifas más bajas.
Características específicas para desarrolladores:
Nova-3: más del 90% de precisión en condiciones ruidosas del mundo real
Streaming ASR con latencia inferior a 300 ms
Despliegue local para entornos sensibles a los datos
Inyección de vocabulario personalizado para términos específicos del sector
Diarización de interlocutores en tiempo real y por lotes
Cumple con SOC 2 Tipo II e HIPAA
Pros:
El mejor ASR robusto contra el ruido para telefonía del mundo real.
Latencia de transmisión inferior a 300 ms.
Comunidad de más de 200,000 desarrolladores.
Despliegue local.
$200 en créditos gratuitos.
Impulsa más de 140,000 llamadas empresariales por hora.
Contras:
Solo capa de ASR: requiere un stack de orquestación completo a su alrededor.
No cuenta con gestión de conversaciones, TTS ni telefonía de forma nativa.
La diarización de interlocutores con alta precisión requiere configuración adicional.
Lo que la hace única: ASR entrenado de extremo a extremo con ruido que procesa directamente el audio de telefonía analógica, el reconocimiento de voz más preciso para producción para stacks de agentes de voz que operan en condiciones acústicas del mundo real.
5. ElevenLabs Conversational AI — El mejor para calidad de voz + API para desarrolladores
Calificación G2: 4.8/5 en Product Hunt (más de 50 reseñas).
Ideal para: Equipos de desarrolladores donde la naturalidad de la voz es la métrica de calidad principal, construyendo experiencias telefónicas de IA de cara a la marca donde los usuarios no noten que están hablando con una IA.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente un día. El modelo TTS Flash v2.5 de ElevenLabs logra una latencia de síntesis inferior a 100 ms, la generación de voz más rápida de esta lista. El modelo 11v3 produce voces con emoción, control del ritmo y vacilaciones naturales, controladas mediante puntuación y etiquetas de audio ([laugh], [sad]) en lugar de ajuste de parámetros.
El producto Conversational AI añade una infraestructura de conversación adecuada: modelo de toma de turnos, autodetección de múltiples idiomas, RAG contra sus propios documentos y la posibilidad de traer su propio LLM. Para el despliegue telefónico en producción, la integración de la telefonía requiere de Retell AI o Telnyx como capa de operador.
La brecha documentada en producción: el monitoreo y la observabilidad son limitados. Algunas empresas han creado productos enteros (Cekura, $2.4M recaudados) específicamente para proporcionar infraestructura de pruebas de regresión sobre ElevenLabs Conversational AI, una brecha que importa para los equipos que iteran con agentes en producción.
Lo que dicen los usuarios de G2 y la comunidad:
"La calidad de voz de ElevenLabs es realmente diferente a la de cualquier otra plataforma. El modelo 11v3 no solo lee texto, sino que lo interpreta. Para cualquier experiencia telefónica de IA dirigida al cliente donde la voz de la marca importe, es la única plataforma que vale la pena considerar." — Reseña de la comunidad de ElevenLabs
"La brecha de monitoreo en producción es real. Planifique su stack de observabilidad antes de lanzar en vivo; necesitará herramientas de terceros para comprender lo que sucede a gran escala." — Reseña de ElevenLabs (profesional técnico)
Precios: Desde $5/mes para el acceso básico. Costo real total con telefonía: $0.10–$0.25/minuto. Personalizado para empresas.
Características específicas para desarrolladores:
Síntesis de TTS en menos de 100 ms a través de Flash v2.5
Más de 70 idiomas con calidad de acento nativo
Modelo 11v3 con control de emoción y expresión a través de etiquetas
Integración de RAG contra bases de conocimientos personalizadas
Trae tu propio LLM
SDK para Python y TypeScript
Clonación de voz a partir de 3 segundos de audio
Pros:
TTS en menos de 100 ms: la síntesis más rápida de esta lista.
Calidad de voz de referencia en la industria.
Más de 70 idiomas de forma nativa.
Trae tu propio LLM.
Clonación de voz.
SDK limpios para Python/TypeScript.
Contras:
Monitoreo de producción limitado: requiere herramientas de observabilidad de terceros.
No se puede implementar como un sistema telefónico independiente sin una capa de telefonía adicional.
La latencia en el mundo real varía según la región bajo carga concurrente.
El costo real de producción es superior al precio anunciado.
Lo que la hace única: Flash v2.5 con síntesis inferior a 100 ms: el techo de calidad de voz que las comparaciones de marketing de todas las demás plataformas citan como el estándar a superar.
6. Telnyx Voice AI — El mejor para desarrolladores que desean un control total de la infraestructura
Calificación G2: 4.3/5
Ideal para: Equipos de desarrolladores que desean ser dueños de todo el stack de IA de voz, desde la telefonía hasta la inferencia, con una infraestructura de GPU ubicada en el mismo lugar que elimina la acumulación de latencia entre API.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente de 1 a 2 días de configuración por parte del desarrollador. La arquitectura de Telnyx es única en esta lista: al ubicar la inferencia de GPU (STT, LLM, TTS) en los mismos puntos de presencia globales que su infraestructura de telefonía de nivel de operador, Telnyx elimina los saltos de API entre servicios que causan la acumulación de latencia en configuraciones de múltiples proveedores.
La implicación en producción: latencia de extremo a extremo inferior a 200 ms en producción, la más rápida de esta lista. La consistencia de la P99 bajo carga concurrente también es la más sólida, porque los saltos de red entre los componentes de procesamiento se miden en microsegundos (mismo centro de datos) en lugar de milisegundos (llamadas API entre regiones).
Lo que dicen los usuarios de G2 (4.3/5):
Los usuarios de G2 elogian constantemente la confiabilidad de la infraestructura y la consistencia de la latencia de Telnyx como la principal ventaja para el desarrollador, específicamente la eliminación de los picos de latencia que ocurren cuando los datos deben viajar entre proveedores externos de STT, LLM, TTS y telefonía en regiones separadas.
Precios: Desde $0.07/minuto con descuentos por volumen. Personalizado para empresas. Requiere un desarrollador o integrador de sistemas para una configuración completa.
Características específicas para desarrolladores:
Inferencia de GPU y telefonía ubicadas en el mismo lugar: elimina la acumulación de latencia entre API
Latencia de extremo a extremo inferior a 200 ms en producción
Control total de todo el stack (STT, LLM, TTS y telefonía en una sola plataforma)
Cobertura global de PSTN en más de 180 países
Soporte para BYOC y BYOL
SLA de tiempo de actividad del 99.999% de nivel de operador
Pros:
Latencia de producción inferior a 200 ms: la más rápida de esta lista.
Elimina la acumulación de latencia a nivel de infraestructura.
SLA de tiempo de actividad de 99.999%.
Cobertura global de nivel de operador.
Todo el stack en una sola plataforma.
Contras:
Requiere conocimientos de ingeniería: no es adecuado para equipos no técnicos.
Calificación de G2 (4.3) inferior a la de Retell (4.8).
Complejidad de configuración elevada.
Una comunidad de desarrolladores menos madura que la de Vapi.
Lo que la hace única: Telefonía e inferencia de IA ubicadas en el mismo lugar: la única plataforma que elimina la latencia entre API a nivel de infraestructura, ofreciendo un rendimiento en producción inferior a 200 ms que los stacks de múltiples proveedores no pueden igualar.
7. LiveKit — El mejor para medios en tiempo real + marco de agentes de voz
Calificación G2: Aún no es significativa: plataforma en fase inicial
Ideal para: Equipos de desarrolladores que crean aplicaciones de medios en tiempo real (videollamadas, transmisiones de audio, WebRTC) que desean añadir funciones de agentes de voz con IA a una infraestructura de medios en tiempo real ya existente.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente un día. La infraestructura de código abierto en tiempo real de LiveKit maneja WebRTC, SFU y el enrutamiento de audio/video, y el marco de Agents añade capacidades de voz de IA sobre esto. Para los equipos que ya utilizan LiveKit para medios en tiempo real, añadir IA de voz no requiere reemplazar la capa de medios.
La ventaja específica para desarrolladores: LiveKit es de código abierto y autoalojable. Los equipos con requisitos de residencia de datos (salud, finanzas, gobierno) pueden implementar todo el stack en su propia infraestructura. Los SDK de Agents para Python/JavaScript/Go proporcionan interfaces con tipos para construir agentes de voz que se integran directamente con la arquitectura de salas en tiempo real de LiveKit.
Precios: Gratis para autoalojado. Planes en la nube desde $0.002/minuto. Personalizado para empresas.
Características específicas para desarrolladores:
De código abierto y autoalojable
Marco de Agents para IA de voz con SDK con tipos para Python/JS/Go
WebRTC + SFU para medios en tiempo real junto con agentes de voz
Trae tu propio STT, LLM, TTS
Servidor de tuberías: cadenas de procesamiento de audio de múltiples pasos
Cumplimiento autoalojado: control total de la residencia de datos
Pros:
De código abierto y autoalojable: cero dependencia de un proveedor.
El mejor para equipos que necesitan un control total de la infraestructura.
El marco de Agents proporciona abstracciones limpias para la IA de voz.
Comunidad de desarrolladores activa.
Servidor de tuberías para procesamiento de audio complejo.
Contras:
Requiere recursos de ingeniería para autoalojar y mantener.
No hay soporte de producción gestionado sin un plan empresarial.
Herramientas de voz de IA menos maduras que Retell o Vapi para casos de uso puros de agentes telefónicos.
Lo que la hace única: El único marco de agentes de voz y medios en tiempo real totalmente de código abierto: los equipos con preocupaciones estrictas sobre la residencia de datos, el cumplimiento o la dependencia de proveedores pueden autoalojar el stack completo sin dependencias externas.
8. AssemblyAI — El mejor ASR para confiabilidad en producción centrada en desarrolladores
Calificación G2: 4.8/5
Ideal para: Equipos de desarrolladores que necesitan un ASR confiable en producción con funciones de inteligencia de voz (diarización de interlocutores, análisis de sentimiento y moderación de contenido) integradas sin configuración adicional.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente 30 minutos. La experiencia de desarrollo de AssemblyAI es la más consistente en todas nuestras pruebas: la documentación de la API es de nivel de producción (no solo ejemplos de inicio rápido), los mensajes de error son procesables y la API de WebSocket de transmisión maneja el audio en tiempo real de manera limpia.
El diferenciador específico para desarrolladores frente a Deepgram: AssemblyAI incluye funciones de inteligencia de voz (diarización de interlocutores, análisis de sentimiento, detección de entidades, seguridad de contenido) como endpoints de API de primera clase en lugar de complementos separados. Para stacks de agentes de voz donde el análisis de llamadas es tan importante como la conversación del agente, esta integración reduce el número de pasos de procesamiento posterior requeridos.
Lo que dicen los usuarios de G2 (4.8/5):
"AssemblyAI ha construido una sólida reputación como una plataforma de IA de voz centrada en la API, con un enfoque en la experiencia del desarrollador y la confiabilidad en producción. La transcripción por transmisión es sólida y la documentación se mantiene firme en producción, no solo en tutoriales de inicio rápido." — Contexto de reseña de G2 (desarrollador profesional)
Precios: Transcripción por transmisión a $0.0043/minuto. $0.000025/token para LeMUR (funciones de LLM). Nivel gratuito generoso. Personalizado para empresas.
Características específicas para desarrolladores:
Streaming ASR con inteligencia de voz integrada
Diarización de interlocutores estándar (no como complemento)
Análisis de sentimiento, detección de entidades y seguridad de contenido a través de API
LeMUR: comprensión de audio impulsada por LLM (resumir, hacer preguntas sobre el audio)
Cumple con SOC 2 Tipo II
Transmisión en tiempo real y por lotes asíncronos desde una sola API
Pros:
4.8/5 G2: empatado con el ASR mejor valorado de esta lista.
Inteligencia de voz integrada (diarización, sentimiento, entidades).
Experiencia de desarrollo y documentación limpias.
Transmisión confiable en producción.
Cumple con SOC 2.
Contras:
Solo capa de ASR: requiere un stack de orquestación completo para el despliegue del agente de voz.
Costo por minuto ligeramente superior al de Deepgram.
Sin TTS ni telefonía.
Lo que la hace única: ASR con inteligencia de voz integrada: la única capa de ASR que proporciona identificación de interlocutores, análisis de sentimiento y extracción de entidades en la misma llamada de API que la transcripción, reduciendo la complejidad del stack de procesamiento posterior.
9. Cartesia — El mejor TTS de baja latencia para stacks de voz de desarrolladores
Calificación G2: Aún no es significativa: plataforma más reciente
Ideal para: Equipos de desarrolladores que optimizan la calidad de la voz y la latencia del TTS en la capa de síntesis, especialmente para casos de uso de agentes de voz donde una latencia de TTS de 90 ms frente a 500 ms marca la diferencia entre una conversación natural y una robótica.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente 30 minutos. El modelo Sonic-3 de Cartesia logra un tiempo hasta el primer audio de 90 ms, el TTS más rápido que medimos. Para los stacks de agentes de voz donde el TTS suele ser el componente más lento, esta ventaja de latencia se percibe directamente en la naturalidad de la conversación.
La clonación de voz a partir de 3 segundos de audio es el umbral más bajo de esta lista, lo que permite la creación rápida de personalidades de voz para agentes de voz de IA específicos de la marca. La API de transmisión por WebSocket permite la generación de audio en tiempo real para conversaciones telefónicas en vivo.
Precios: Básico desde $4/mes; API de pago por uso. Personalizado para empresas. El uso comercial está restringido en el plan gratuito.
Características específicas para desarrolladores:
Tiempo hasta el primer audio de 90 ms: el TTS más rápido probado
Clonación de voz a partir de 3 segundos de audio
Transmisión por WebSocket para síntesis en tiempo real
Más de 30 idiomas
API limpia para desarrolladores con SDK para Python/TypeScript
Plataforma de agentes de voz dedicada (Line) para aplicaciones de transmisión por WebSocket
Pros:
La latencia de TTS más rápida probada (90 ms).
Clonación de voz en 3 segundos.
Transmisión por WebSocket.
Experiencia de desarrollo limpia.
El precio de suscripción más bajo de esta lista.
Contras:
Solo capa de TTS: requiere un stack de orquestación completo.
El uso comercial está restringido en el plan gratuito.
Biblioteca de idiomas más pequeña que la de ElevenLabs.
Plataforma más reciente con una comunidad de desarrolladores más pequeña.
Lo que la hace única: Síntesis de TTS de 90 ms: cuando el flujo de conversación del agente de voz combina la calidad de voz de ElevenLabs a la velocidad de Cartesia, el resultado es la mejor relación entre naturalidad y latencia disponible en cualquier stack de TTS para desarrolladores.
10. Voiceflow — El mejor diseño visual de conversaciones para desarrolladores
Calificación G2: 4.7/5
Ideal para: Equipos de desarrolladores que desean diseñar, prototipar y probar flujos de conversación complejos de forma visual antes de escribir código de producción, particularmente para conversaciones ramificadas de múltiples intenciones donde el mapeo del estado es la parte difícil.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente dos días para el diseño de conversación completo y el despliegue en producción. El creador visual de máquinas de estado de Voiceflow es el entorno de diseño de conversaciones más maduro de esta lista: cada intención, ruta, respaldo y acción de cumplimiento se define explícitamente en un gráfico de nodos antes del despliegue.
La ventaja específica para desarrolladores: el diseño visual de conversaciones detecta casos límite antes de la producción. Un registro de siniestros complejo, una calificación de clientes potenciales de múltiples pasos o un flujo de citas médicas con más de 30 rutas posibles es mucho más fácil de validar de forma visual que a través del código. Voiceflow exporta luego la lógica de conversación a código, o la implementa a través de API en Retell, Twilio o telefonía personalizada.
Lo que dicen los usuarios de G2 (4.7/5):
"La capacidad de prototipar y probar flujos conversacionales rápidamente se destacó, especialmente para los equipos que refinan los recorridos de los usuarios antes del despliegue. El entorno de diseño visual detecta ambigüedades que nunca habríamos encontrado en el código hasta que estuvieran en vivo." — Reseña de G2, Voiceflow
Precios: Gratis (2 agentes); Pro desde $50/mes/editor; Team desde $125/mes; Personalizado para empresas.
Características específicas para desarrolladores:
Creador visual de conversaciones con máquina de estados
Exporte la lógica de conversación a código o impleméntela a través de API
Despliegue multicanal (voz, chat, SMS) desde un solo diseño
Arquitectura centrada en la API para actualizaciones programáticas de agentes
Integración con Retell, Twilio y telefonía personalizada
Más de 100 integraciones prediseñadas
Pros:
El mejor entorno de diseño visual de conversaciones.
El modelo de máquina de estados detecta casos límite en la preproducción.
Multicanal desde un solo diseño.
Centrado en la API para actualizaciones programáticas.
4.7/5 G2 de una base de reseñas significativa.
Contras:
El despliegue de voz requiere telefonía externa (Retell, Twilio), no es independiente.
La ejecución de voz en producción es menos madura que en plataformas de voz puras.
Algunos usuarios reportan la necesidad de infraestructura adicional para despliegues complejos en tiempo real.
Lo que la hace única: Arquitectura visual de conversación antes del código: la única herramienta para desarrolladores que hace práctico diseñar y validar visualmente flujos de conversación ramificados complejos, detectando fallas de producción antes de que lleguen a los usuarios.
El marco de decisión para desarrolladores: ¿Qué capa necesita?
¿Desea lanzar un agente de voz en funcionamiento esta semana sin construir infraestructura?
Retell AI (configuración en 45 minutos, listo para producción, BYOL/BYOC). Brilo.ai (configuración en 7 minutos, integrado con API, plataforma completa). Ambos eliminan las 400 horas de ingeniería del desarrollo de orquestación.
¿Necesita la máxima flexibilidad de componentes y está dispuesto a asumir la complejidad de la orquestación?
Vapi.ai: traiga su propio STT, LLM, TTS; comunidad de más de 500,000 desarrolladores; sea dueño de cada componente de manera independiente.
¿Necesita la mejor base de ASR para su propio stack de voz?
Deepgram Nova-3 para audio de telefonía robusto contra el ruido. AssemblyAI para confiabilidad en producción con inteligencia de voz integrada.
¿Necesita la mejor calidad de voz y la síntesis de TTS más rápida?
ElevenLabs Flash v2.5 para síntesis en menos de 100 ms y una naturalidad de referencia en la industria. Cartesia Sonic-3 para TTS de 90 ms a un precio más bajo.
¿Necesita un control total de la infraestructura con telefonía e IA ubicadas en el mismo lugar?
Telnyx: latencia de producción inferior a 200 ms, sin saltos de API intermedios, confiabilidad de nivel de operador.
¿Está construyendo sobre código abierto o autoalojando por motivos de cumplimiento?
Marco LiveKit Agents: totalmente de código abierto, autoalojable, sin dependencia de proveedores.
¿Necesita diseñar flujos de conversación complejos visualmente antes de escribir código?
Voiceflow: creador visual con máquina de estados y luego despliegue en Retell o Twilio.
El modelo de costo real que todo desarrollador debería ejecutar
Antes de comprometerse con cualquier plataforma, modele el costo real total según su volumen de producción proyectado. La tarifa por minuto anunciada casi nunca coincide con el costo real de producción:
Ejemplo: 10,000 llamadas/mes, promedio de 3 minutos, usando Vapi con proveedores externos:
Orquestación de Vapi: $0.05 × 30,000 min = $1,500
Deepgram Nova-3 STT: $0.0043 × 30,000 min = $129
LLM GPT-4o: ~$0.10 × 30,000 min = $3,000 (depende en gran medida del número de turnos)
TTS de ElevenLabs: ~$0.03 × 30,000 min = $900
Telefonía de Twilio: ~$0.013 × 30,000 min = $390
Total: ~$5,919/mes frente a los $0.05/minuto anunciados
Mismo volumen en Retell AI:
Retell total integrado: $0.07 × 30,000 min = $2,100
Telefonía de Twilio: ~$0.013 × 30,000 min = $390
Total: ~$2,490/mes
El costo de ingeniería de construir y mantener el stack de Vapi frente al uso de la orquestación integrada de Retell es adicional; por lo general, representa más de 400 horas de trabajo de desarrolladores senior.
Preguntas frecuentes
¿Cuál es la diferencia entre una plataforma de IA de voz y una API de IA de voz?
Una API de IA de voz proporciona un componente de la pila — Deepgram para ASR, ElevenLabs para TTS, o OpenAI para LLM. Una plataforma de IA de voz orquesta múltiples componentes en un agente de voz desplegable, gestionando la alternancia de turnos, la interrupción del usuario (barge-in), la telefonía y la lógica de la conversación. La mayoría de los desarrolladores comienzan con APIs y descubren que necesitan una plataforma.
¿Qué es el traer tu propio modelo (BYOM, por sus siglas en inglés) y por qué es importante para los desarrolladores?
BYOM (Trae tu propio modelo) significa que puedes intercambiar los componentes de IA (LLM, STT, TTS) en la pila de tu agente de voz de forma independiente. Sin BYOM, quedas limitado a los modelos predeterminados de la plataforma, que podrían no ser la mejor opción para tu caso de uso, idioma o requisitos de cumplimiento. Tanto Vapi como Retell ofrecen BYOM completo. Brilo.ai ofrece opciones de ASR configurables.
¿Cuál es el tiempo de puesta en producción oficial más rápido para las plataformas de voz para desarrolladores?
Brilo.ai: 7 minutos (plataforma integrada, sin código). Deepgram/AssemblyAI: ~30 minutos (solo ASR). Retell AI: ~45 minutos (agente completo). Vapi: ~1 día completo de desarrollador (con configuración de proveedor externo). Telnyx: 1–2 días (configuración de infraestructura). LiveKit autoalojado: de días a semanas (despliegue completo de infraestructura).
¿Qué es la acumulación de latencia y cómo la evitan los desarrolladores?
La acumulación de latencia es el retraso acumulado al encadenar múltiples llamadas de API externas (STT → LLM → TTS → telefonía), donde cada salto añade entre 50 y 150 ms. En momentos de carga máxima, una pila de 4 proveedores puede alcanzar los 1,400 ms en P99. Soluciones: utilizar una plataforma con orquestación integrada (Retell, Brilo.ai), usar infraestructura co-ubicada (Telnyx) o implementar los componentes en la misma región de la nube.
¿Qué plataforma de voz de IA tiene la comunidad de desarrolladores más grande?
Vapi es el más grande con más de 500,000 desarrolladores registrados. Deepgram tiene más de 200,000 desarrolladores que utilizan sus APIs. Retell cuenta con más de 3,000 empresas en producción con más de 30 millones de llamadas al mes. ElevenLabs tiene una gran comunidad de desarrolladores creativos, pero menos profesionales en agentes de voz.
¿Qué certificaciones de cumplimiento de normativa deberían tener las plataformas de voz para desarrolladores?
Para el sector salud: HIPAA (autoservicio, no solo para empresas). Para servicios financieros: SOC 2 Tipo II. Para despliegues en la UE: GDPR. Para el procesamiento de pagos: PCI DSS. Retell AI, Deepgram, AssemblyAI y Telnyx ofrecen autoservicio compatible con SOC 2 e HIPAA. Cognigy ofrece despliegue local (on-premise) para los requisitos de residencia de datos más estrictos.
¿Cuál es el gasto mínimo para el desarrollo de IA de voz en producción?
Brilo.ai: $0 (plan gratuito, 10 minutos/mes). Deepgram: $0 ($200 en créditos gratuitos). Retell AI: $0 ($10 en créditos gratuitos, ~60 minutos). Vapi: $0 ($10 en créditos gratuitos). ElevenLabs: $5/mes. Cartesia: $4/mes. La mayoría de las plataformas permiten realizar pruebas reales antes de cualquier suscripción.
El resultado final
El mercado de plataformas de voz de IA para desarrolladores ha madurado en 2026, pero aún es fácil elegir la capa incorrecta, construir una infraestructura que una plataforma ya habría proporcionado o descubrir problemas de latencia en producción que los entornos de demostración ocultaban. Los equipos que realizan lanzamientos más rápido y gastan menos son aquellos que identifican correctamente qué capa necesitan poseer y qué capas deberían comprar.
Las mejores plataformas de voz de IA para desarrolladores según el caso de uso:
Tiempo más rápido para producción: Brilo.ai (7 min, plataforma completa integrada por API)
Mejor plataforma general para desarrolladores: Retell AI (4.8/5 G2, BYOL/BYOC, configuración en 45 min)
Máxima flexibilidad de componentes: Vapi.ai (más de 500k desarrolladores, BYOK completo)
Mejor base de ASR (robusta al ruido): Deepgram Nova-3
Mejor calidad de voz + síntesis TTS: ElevenLabs Flash v2.5
Mejor control de infraestructura: Telnyx (menos de 200 ms, coubicada)
Código abierto + autohospedado: LiveKit Agents
Mejor ASR + inteligencia de voz: AssemblyAI
Síntesis TTS más rápida: Cartesia Sonic-3 (90 ms)
Mejor herramienta de diseño conversacional: Voiceflow
Todos los insights
Artículos
Las 10 mejores plataformas de voz de IA para desarrolladores en 2026 (probadas y revisadas)
Probamos 10 plataformas de voz con inteligencia artificial para desarrolladores: comparamos la calidad de la API, la arquitectura de latencia, la flexibilidad de BYOM (trae tu propio modelo), las opiniones de G2 y los costos reales para el 2026.
Pasamos ocho semanas evaluando plataformas de voz de IA específicamente desde la perspectiva de un desarrollador: calidad de la API, profundidad de la documentación, arquitectura de latencia, flexibilidad para usar tu propio modelo, observabilidad en producción, modelado de costos reales y la brecha entre la demostración y la producción. Construimos agentes de voz reales en cada plataforma, obtuvimos reseñas exclusivamente de G2 y Reddit, y analizamos puntos de referencia independientes. Un miembro de nuestro equipo utiliza Brilo.ai como cliente de pago; lo señalamos donde corresponde.
Esto es lo que encontramos.
Las cuatro capas del stack de voz de IA para desarrolladores
La mayoría de las comparaciones de plataformas de voz de IA para desarrolladores fallan porque comparan herramientas de diferentes capas del stack como si fueran competidores directos. No lo son.
Antes de elegir una plataforma, comprenda qué capa necesita controlar su equipo:
Capa | Qué hace | Quién la controla | Ejemplos |
|---|---|---|---|
Capa 1 — Infraestructura de voz | ASR (reconocimiento de voz), TTS (texto a voz), telefonía | Equipos de infraestructura/plataforma | Deepgram, AssemblyAI, Telnyx, Google Cloud STT |
Capa 2 — Orquestación de voz | Conecta STT + LLM + TTS + telefonía en una tubería de conversación | Desarrolladores backend | Vapi, Retell AI, LiveKit |
Capa 3 — Marco de conversación | Lógica de conversación impulsada por LLM, contexto de múltiples turnos, llamada a funciones | Desarrolladores de IA/ML | Voiceflow, Rasa, LangChain + Retell |
Capa 4 — Plataforma completa | Todas las capas integradas, desplegadas y monitoreadas | Equipos de producto/operaciones | Brilo.ai, Cognigy, PolyAI |
El error de desarrollo más costoso: construir la Capa 2 desde cero (unir Deepgram + OpenAI + ElevenLabs + Twilio con una orquestación personalizada) cuando una plataforma de Capa 2 como Retell ya resuelve esto, con mejor latencia y un menor costo total de ingeniería.
El segundo error más costoso: elegir una plataforma de Capa 4 (Cognigy, PolyAI) cuando su caso de uso solo necesita la Capa 2, pagando por una gobernanza empresarial que nunca utilizará.
Lo que Reddit realmente dice sobre las plataformas de voz de IA para desarrolladores
Los hilos de Reddit en r/MachineLearning, r/webdev y r/SaaS revelan temas consistentes de desarrolladores que han implementado IA de voz en producción.
Sobre el costo real de construir su propio stack:
"Construimos nuestra propia orquestación sobre Deepgram + GPT-4o + ElevenLabs pensando que ahorraríamos dinero. Después de 3 meses de tiempo de ingeniería, calculamos el costo oculto: 2 ingenieros senior durante 400 horas cada uno. Con nuestra tarifa completa, eso representa un costo de ingeniería de $120,000 para construir algo por lo que Retell cobra $0.07/min. Habríamos lanzado 10 semanas antes y gastado una fracción de lo que realmente gastamos." — Reddit, r/SaaS
Sobre la decisión entre Vapi y Retell:
"Vapi si quieres ser dueño de cada componente y tienes los recursos de ingeniería para mantenerlo. Retell si quieres lanzar rápido y que la plataforma se encargue de la complejidad de la orquestación. La elección es realmente: '¿quieres ser una empresa de infraestructura de voz o quieres usar la IA de voz para construir tu producto?'" — Reddit, r/MachineLearning
Sobre el problema de la acumulación de latencia:
"Cada salto de API añade entre 50 y 150 ms. STT + LLM + TTS + telefonía de cuatro proveedores = 200–600 ms de pura sobrecarga de red antes de cualquier procesamiento. Medimos 1,400 ms de P99 en nuestro stack de Vapi en horas pico. Movimos el ASR de Deepgram a la misma región que nuestro LLM y recortamos 200 ms de inmediato." — Reddit, r/webdev
Nuestra metodología de clasificación específica para desarrolladores
Criterio | Peso | Qué medimos |
|---|---|---|
Calidad de la API y documentación | 25% | Tiempo hasta la primera llamada, exhaustividad de la documentación, calidad del SDK, confiabilidad del webhook |
Flexibilidad para traer tu propio modelo (BYOM) | 20% | ¿Se pueden intercambiar STT, LLM y TTS de forma independiente? |
Latencia en producción y confiabilidad P99 | 20% | P50 y P99 bajo carga concurrente, no en condiciones de demostración |
Observabilidad y depuración | 15% | Registros de llamadas, transcripciones, atribución de errores, pruebas A/B |
Transparencia del costo real | 10% | Costo total incluyendo cada capa |
Preparación para el cumplimiento | 10% | SOC 2, HIPAA, GDPR — autoservicio o solo para empresas |
Tabla comparativa de TL;DR para desarrolladores
Plataforma | Capa | BYOM | Calificación G2 | Tiempo hasta primera llamada | Precio inicial |
|---|---|---|---|---|---|
Brilo.ai | Plataforma completa | ⚙️ Configurable | — | 7 min | Gratis / $149/mes |
Retell AI | Orquestación + completa | ✅ Total | 4.8/5 | ~45 min | $0.07/min |
Vapi.ai | Orquestación | ✅ BYOK total | 4.2/5 | ~1 día | $0.05/min base |
Deepgram | Infraestructura ASR | N/A (Capa ASR) | 4.7/5 | ~30 min | $0.0043/min |
ElevenLabs | TTS + IA conversacional | ✅ Parcial | 4.8/5 (PH) | ~1 día | $5/mes |
Telnyx | Infraestructura full-stack | ✅ Total | 4.3/5 | ~1-2 días | $0.07/min |
LiveKit | Medios en tiempo real + orquestación | ✅ Total | — | ~1 día | Gratis / $0.002/min |
AssemblyAI | Infraestructura ASR | N/A (Capa ASR) | 4.8/5 | ~30 min | $0.0043/min |
Cartesia | Infraestructura TTS | N/A (Capa TTS) | — | ~30 min | $4/mes |
Voiceflow | Marco de conversación | ✅ Parcial | 4.7/5 | ~2 días | Gratis / $50/mes |
1. Brilo.ai — El mejor en general para desarrolladores que quieren lanzar rápido
Ideal para: Equipos de desarrolladores que necesitan una plataforma de agentes de voz lista para producción, con acceso a API para integración, opciones configurables de STT y LLM, y la ruta más rápida desde "necesitamos IA de voz" hasta "está en vivo en producción".
Por qué Brilo pertenece a una lista de plataformas para desarrolladores:
La mayoría de las plataformas dirigidas a desarrolladores requieren ensamblar un stack de múltiples proveedores antes de la primera llamada. Brilo proporciona el stack integrado completo con acceso a la API, lo que significa que los desarrolladores pueden integrar Brilo en productos y flujos de trabajo existentes a través de la API mientras siguen controlando lo que más importa: los flujos de conversación, la lógica de escalación, la integración de CRM y la gestión de la base de conocimientos.
Nos registramos, conectamos nuestra base de conocimientos (Brilo rastreó automáticamente nuestro sitio web) y tuvimos un agente de voz de IA en vivo manejando llamadas entrantes reales en 7 minutos y 14 segundos. Para pruebas específicas de desarrolladores, expusimos los endpoints de integración de la API, conectamos un CRM de prueba mediante webhook y verificamos que las transcripciones de llamadas, los datos de intención y la información de la persona que llama se propagaran correctamente a los sistemas posteriores en un plazo de 2 minutos tras finalizar cada llamada.
El cálculo del ROI para desarrolladores es específico: los equipos que construyen IA de voz desde cero sobre infraestructura pura (Deepgram + OpenAI + ElevenLabs + Twilio) documentan más de 400 horas de ingeniería antes del despliegue en producción. La plataforma integrada de Brilo elimina ese desarrollo: los desarrolladores controlan la integración y la lógica de conversación, no la infraestructura de orquestación.
Divulgación: uno de los miembros de nuestro equipo es un cliente de pago de Brilo. Sometimos a pruebas de esfuerzo la confiabilidad de la API y el comportamiento del webhook específicamente.
Registro → primera llamada de API: Menos de 30 minutos
Características específicas para desarrolladores:
API REST y webhooks para una integración completa en productos existentes
Proveedores de ASR configurables: cámbielos para casos de uso con ruido específico
API de base de conocimientos: inserte contenido mediante programación sin acceso al panel
Transcripciones de llamadas en tiempo real y datos de intención a través de webhook
Integración de CRM a través de API (HubSpot, Salesforce, personalizada)
API de análisis de llamadas para el procesamiento posterior a la llamada
Precios:
Plan gratuito: Gratis — 10 minutos/mes, 1 agente de IA, 1 espacio de trabajo, soporte de la comunidad
Plan Pro: $149/mes — 600 minutos, 3 agentes de IA, 3 espacios de trabajo, 1 número de teléfono de IA, uso adicional a 16 centavos/min, canal de Slack privado
Plan Growth: $499/mes — 2,500 minutos, agentes de IA ilimitados, 5 espacios de trabajo, 1 número de teléfono de IA, uso adicional a 14 centavos/min, canal de Slack privado
Plan personalizado: Consúltenos — más de 5,000 minutos, agentes de IA ilimitados, espacios de trabajo ilimitados, uso adicional a <14 centavos/min, incorporación personalizada
Contras:
No es una capa de orquestación pura: los desarrolladores que deseen controlar cada componente de ASR, LLM y TTS de forma independiente deberían considerar Retell o Vapi
Las herramientas de observabilidad en producción (paneles de latencia P99, atribución de errores por componente) son menos maduras que las plataformas dedicadas orientadas a desarrolladores
Para los equipos que desean autoalojarse o implementar en su propia infraestructura en la nube, Telnyx o Rasa ofrecen opciones locales
Lo que la hace única: El camino de desarrollo más rápido hacia la IA de voz en producción: una plataforma integrada con acceso completo a la API que elimina las 400 horas de ingeniería de desarrollo de orquestación sin sacrificar la flexibilidad de integración.
Pruébela gratis: brilo.ai — $0 para comenzar, documentación de API disponible de inmediato.
2. Retell AI — La mejor plataforma de voz en general para desarrolladores
Calificación G2: 4.8/5 — 1,472 reseñas | Premio G2 2026 al mejor software de IA agéntica
Ideal para: Equipos de desarrolladores que desean una IA de voz de nivel de producción con control total de la API, flexibilidad para traer su propio LLM y la experiencia de desarrollo mejor validada por G2 en la categoría.
Nuestra experiencia de prueba:
Un desarrollador de nuestro equipo conectó una línea SIP de Twilio y tuvo un agente de soporte entrante en funcionamiento en 45 minutos. El creador visual de flujos de conversación asignó un guion de calificación de 6 pasos con bifurcaciones condicionales, lógica de transferencia directa y un nodo de respaldo para intenciones no reconocidas; luego, la API subyacente estuvo disponible para actualizaciones programáticas de flujos desde nuestro flujo de trabajo de CI/CD.
Las ventajas específicas para desarrolladores sobre Vapi: la orquestación patentada de Retell maneja la parte más difícil del stack de voz (toma de turnos, detección de interrupciones, gestión de silencios) sin que los desarrolladores tengan que escribir lógica personalizada para ello. Retell también proporciona pruebas A/B de forma nativa, análisis posterior a la llamada con sentimiento e intención, y soporte de webhooks que propaga los datos de la llamada a los sistemas posteriores de manera confiable.
Lo que dicen los usuarios de G2 (4.8/5, 1,472 reseñas):
"Lo que más me gusta de Retell AI es lo naturales que se sienten las conversaciones de voz. La API es flexible y permite integrar llamadas de IA en sistemas existentes sin demasiada complejidad. Es una plataforma potente si deseas automatizar las interacciones telefónicas manteniendo una experiencia de cliente profesional." — Reseña verificada de G2, Retell AI
"Por fin, una plataforma simplificada de IA de voz que realmente funciona en producción. La confiabilidad es consistente: latencia estable, interrupción confiable y la configuración es intuitiva una vez que superas la curva de aprendizaje inicial. El análisis posterior a la llamada nos brinda los datos estructurados que necesitamos para alimentar nuestro CRM." — Reseña verificada de G2, Retell AI
Lo que dice Reddit:
Las comunidades de desarrolladores de Reddit posicionan específicamente a Retell como la respuesta a la pregunta: "¿quieres ser una empresa de infraestructura de voz o construir tu producto?". El patrón más consistente: los equipos que comenzaron en Vapi para obtener la máxima flexibilidad migran a Retell cuando la escala de producción revela el costo de mantenimiento de la orquestación.
Precios: $0.07/minuto. $10 en créditos gratuitos. Sin tarifas de plataforma. Gestiona más de 30 millones de llamadas al mes para más de 3,000 empresas.
Características específicas para desarrolladores:
Trae tu propio LLM (GPT-4, Claude, Gemini o modelos alojados)
Telefonía BYOC (Twilio, Telnyx, Vonage o el operador de Retell)
Pruebas A/B de flujos de conversación de forma nativa
Análisis posterior a la llamada con intención, sentimiento y entidades
Soporte de webhooks para la integración con CRM y sistemas posteriores
Llamadas a funciones en tiempo real a mitad de la conversación
Cumplimiento de autoservicio SOC 2 Tipo II, HIPAA y GDPR
Pros:
4.8/5 G2 de 1,472 reseñas — la mayor credibilidad.
~600ms P50 con baja fluctuación P99.
BYOL y BYOC completos.
Pruebas A/B.
Análisis posterior a la llamada.
Autoservicio SOC 2/HIPAA/GDPR.
Despliegue local disponible.
Contras:
Solo para desarrolladores: las partes interesadas no técnicas necesitan soporte.
El uso de producción empresarial suele ser de un mínimo de $3,000+/mes.
Curva de aprendizaje para flujos complejos de múltiples nodos.
Respuesta de soporte lenta señalada en reseñas anteriores.
Lo que la hace única: El mejor equilibrio entre el control del desarrollador y la confiabilidad en producción: flexibilidad total de BYOL/BYOC con una orquestación patentada que maneja la complejidad de la conversación que los desarrolladores no quieren construir.
3. Vapi.ai — El mejor para un control máximo del desarrollador
Calificación G2: 4.2/5
Ideal para: Desarrolladores que desean traer sus propios proveedores de STT, LLM y TTS, siendo dueños de cada componente del stack de voz de manera independiente sin dependencia de un proveedor.
Nuestra experiencia de prueba:
Un desarrollador pasó un día entero conectando Deepgram para STT, GPT-4o para el LLM y ElevenLabs para TTS a través de la API de orquestación de Vapi. La flexibilidad es la más fuerte de esta lista: cambie cualquier componente sin tener que reconstruir el agente, encadene agentes especializados dentro de una sola llamada a través de Squads y realice pruebas A/B en combinaciones de voz y modelo.
El compromiso específico relevante para el desarrollador: Vapi es únicamente una capa de orquestación. Asume que los desarrolladores aportarán todo lo demás. Esto significa un mayor tiempo de configuración inicial, la gestión de facturación de múltiples proveedores y la acumulación de latencia cuando los saltos de API abarcan diferentes regiones. La latencia de producción P99 bajo carga concurrente puede alcanzar entre 1,200 y 1,500 ms en configuraciones de múltiples proveedores, por encima del umbral de conversación natural.
Vapi ha procesado más de 300 millones de llamadas y presta servicio a más de 500,000 desarrolladores, la mayor comunidad de desarrolladores de cualquier plataforma de esta lista.
Lo que dicen los usuarios de G2 (4.2/5):
"Después de una semana con Vapi, lo primero que me llamó la atención fue lo rápido que se siente. Está diseñado para desarrolladores, no para principiantes: todo está centrado en la API y es altamente personalizable. Pude enrutar llamadas, manejar interrupciones e introducir contexto en otras API al instante. Incluso se pueden cambiar modelos o ajustar la lógica a mitad de la conversación, lo que brinda a los equipos de desarrollo una flexibilidad real." — Reseña verificada de G2, Vapi AI
"La experiencia de desarrollo es excelente y la API está bien documentada. La principal limitación es que lograr una calidad de producción requiere una gestión cuidadosa de la latencia entre múltiples proveedores; la misma flexibilidad que hace potente a Vapi es también lo que dificulta la confiabilidad en producción." — Reseña verificada de G2, Vapi AI
Lo que dice Reddit:
Las comunidades de desarrolladores de Reddit documentan claramente la posición de Vapi frente a Retell: "Vapi si quieres ser dueño de cada componente. Retell si quieres lanzar rápido y que la plataforma maneje la complejidad de la orquestación." La comunidad de Vapi es activa, grande y técnicamente sofisticada, con la red de soporte entre pares más sólida de cualquier plataforma en esta lista.
Precios: Base de $0.05/minuto (solo orquestación). Costo real total con proveedores externos: $0.10–$0.25/minuto. $10 en créditos gratuitos. 10 llamadas concurrentes en el nivel gratuito. Personalizado para empresas.
Características específicas para desarrolladores:
Trae absolutamente todo: STT, LLM, TTS, telefonía
Squads: encadene múltiples agentes especializados en una sola llamada
Herramientas de prueba automatizadas para la detección de alucinaciones en preproducción
Pruebas A/B para combinaciones de voces y modelos
Llamadas a funciones en tiempo real
Más de 100 idiomas compatibles entre los proveedores
Pros:
Máxima flexibilidad de componentes.
La mayor comunidad de desarrolladores (más de 500,000 desarrolladores).
La base anunciada más baja de $0.05/min.
Squads para cadenas de llamadas multiagente.
Pruebas automatizadas de alucinaciones.
Contras:
Los costos reales totales son de 2 a 5 veces la base anunciada.
La acumulación de latencia de múltiples proveedores degrada la P99.
Totalmente orientado a desarrolladores: no hay interfaz para usuarios comerciales.
La calificación de G2 (4.2) es la más baja de esta lista.
Facturación fragmentada entre proveedores.
Lo que la hace única: La única plataforma donde cada componente (STT, LLM, TTS, telefonía) se puede intercambiar de forma independiente sin tener que reconstruir el agente, lo que proporciona la máxima velocidad de experimentación para los equipos de desarrollo que optimizan cada capa por separado.
4. Deepgram — La mejor infraestructura ASR para stacks de voz de desarrolladores
Calificación G2: 4.7/5
Ideal para: Equipos de desarrolladores que necesitan la base de reconocimiento de voz más precisa y robusta contra el ruido para su stack de agentes de voz, utilizada como la capa de ASR dentro de Retell, Vapi o un marco de orquestación personalizado.
Nuestra experiencia de prueba:
Deepgram no es una plataforma de agentes de voz, sino la capa de ASR que impulsa muchas de las plataformas de esta lista. Más de 200,000 desarrolladores compilan con Deepgram; procesa más de 140,000 llamadas de farmacias CVS por hora con una latencia inferior a 300 ms. Comprender Deepgram es comprender la base de precisión y robustez ante el ruido del mercado de IA de voz para desarrolladores.
El modelo Nova-3 ofrece una precisión superior al 90% en condiciones de telefonía ruidosa, entrenado con audio del mundo real, no con conjuntos de datos académicos limpios. Esto es crucial porque todos los demás componentes de un stack de agentes de voz se encuentran río abajo de la calidad del ASR. Una tasa de error de palabras del 15% no produce un agente un 15% peor, sino que genera confusión en el agente que se acumula a través del LLM y produce respuestas incorrectas.
Lo que dicen los usuarios de G2 (4.7/5):
"Deepgram proporciona una transcripción de voz a texto muy precisa y rápida, incluso para grabaciones de audio largas y transmisiones en tiempo real. Me gusta especialmente la baja latencia para el reconocimiento de voz en tiempo real y la capacidad de manejar diferentes acentos y entornos ruidosos. Ha sido confiable y escalable para su uso en producción." — Reseña verificada de G2, Deepgram
"Me gusta que convierte el habla en texto de manera rápida y precisa, y que funciona bien con diferentes voces y acentos. Su precisión y capacidad para manejar distintos acentos ayudaron mucho al procesar reuniones de varios interlocutores y llamadas grabadas de eventos globales, incluso con ruido de fondo o personas con acentos muy marcados." — Reseña verificada de G2, Deepgram
Lo que dice Reddit:
Las comunidades de desarrolladores de Reddit recomiendan específicamente Deepgram Nova-3 para agentes de voz en producción en entornos ruidosos del mundo real, citando los datos de entrenamiento de telefonía del mundo real como el diferenciador clave frente a los modelos ASR de Google y AWS entrenados con conjuntos de datos más limpios.
Precios: $0.0043/minuto para Nova-3. $200 en créditos gratuitos. Despliegue autogestionado disponible. Transcripción por lotes a tarifas más bajas.
Características específicas para desarrolladores:
Nova-3: más del 90% de precisión en condiciones ruidosas del mundo real
Streaming ASR con latencia inferior a 300 ms
Despliegue local para entornos sensibles a los datos
Inyección de vocabulario personalizado para términos específicos del sector
Diarización de interlocutores en tiempo real y por lotes
Cumple con SOC 2 Tipo II e HIPAA
Pros:
El mejor ASR robusto contra el ruido para telefonía del mundo real.
Latencia de transmisión inferior a 300 ms.
Comunidad de más de 200,000 desarrolladores.
Despliegue local.
$200 en créditos gratuitos.
Impulsa más de 140,000 llamadas empresariales por hora.
Contras:
Solo capa de ASR: requiere un stack de orquestación completo a su alrededor.
No cuenta con gestión de conversaciones, TTS ni telefonía de forma nativa.
La diarización de interlocutores con alta precisión requiere configuración adicional.
Lo que la hace única: ASR entrenado de extremo a extremo con ruido que procesa directamente el audio de telefonía analógica, el reconocimiento de voz más preciso para producción para stacks de agentes de voz que operan en condiciones acústicas del mundo real.
5. ElevenLabs Conversational AI — El mejor para calidad de voz + API para desarrolladores
Calificación G2: 4.8/5 en Product Hunt (más de 50 reseñas).
Ideal para: Equipos de desarrolladores donde la naturalidad de la voz es la métrica de calidad principal, construyendo experiencias telefónicas de IA de cara a la marca donde los usuarios no noten que están hablando con una IA.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente un día. El modelo TTS Flash v2.5 de ElevenLabs logra una latencia de síntesis inferior a 100 ms, la generación de voz más rápida de esta lista. El modelo 11v3 produce voces con emoción, control del ritmo y vacilaciones naturales, controladas mediante puntuación y etiquetas de audio ([laugh], [sad]) en lugar de ajuste de parámetros.
El producto Conversational AI añade una infraestructura de conversación adecuada: modelo de toma de turnos, autodetección de múltiples idiomas, RAG contra sus propios documentos y la posibilidad de traer su propio LLM. Para el despliegue telefónico en producción, la integración de la telefonía requiere de Retell AI o Telnyx como capa de operador.
La brecha documentada en producción: el monitoreo y la observabilidad son limitados. Algunas empresas han creado productos enteros (Cekura, $2.4M recaudados) específicamente para proporcionar infraestructura de pruebas de regresión sobre ElevenLabs Conversational AI, una brecha que importa para los equipos que iteran con agentes en producción.
Lo que dicen los usuarios de G2 y la comunidad:
"La calidad de voz de ElevenLabs es realmente diferente a la de cualquier otra plataforma. El modelo 11v3 no solo lee texto, sino que lo interpreta. Para cualquier experiencia telefónica de IA dirigida al cliente donde la voz de la marca importe, es la única plataforma que vale la pena considerar." — Reseña de la comunidad de ElevenLabs
"La brecha de monitoreo en producción es real. Planifique su stack de observabilidad antes de lanzar en vivo; necesitará herramientas de terceros para comprender lo que sucede a gran escala." — Reseña de ElevenLabs (profesional técnico)
Precios: Desde $5/mes para el acceso básico. Costo real total con telefonía: $0.10–$0.25/minuto. Personalizado para empresas.
Características específicas para desarrolladores:
Síntesis de TTS en menos de 100 ms a través de Flash v2.5
Más de 70 idiomas con calidad de acento nativo
Modelo 11v3 con control de emoción y expresión a través de etiquetas
Integración de RAG contra bases de conocimientos personalizadas
Trae tu propio LLM
SDK para Python y TypeScript
Clonación de voz a partir de 3 segundos de audio
Pros:
TTS en menos de 100 ms: la síntesis más rápida de esta lista.
Calidad de voz de referencia en la industria.
Más de 70 idiomas de forma nativa.
Trae tu propio LLM.
Clonación de voz.
SDK limpios para Python/TypeScript.
Contras:
Monitoreo de producción limitado: requiere herramientas de observabilidad de terceros.
No se puede implementar como un sistema telefónico independiente sin una capa de telefonía adicional.
La latencia en el mundo real varía según la región bajo carga concurrente.
El costo real de producción es superior al precio anunciado.
Lo que la hace única: Flash v2.5 con síntesis inferior a 100 ms: el techo de calidad de voz que las comparaciones de marketing de todas las demás plataformas citan como el estándar a superar.
6. Telnyx Voice AI — El mejor para desarrolladores que desean un control total de la infraestructura
Calificación G2: 4.3/5
Ideal para: Equipos de desarrolladores que desean ser dueños de todo el stack de IA de voz, desde la telefonía hasta la inferencia, con una infraestructura de GPU ubicada en el mismo lugar que elimina la acumulación de latencia entre API.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente de 1 a 2 días de configuración por parte del desarrollador. La arquitectura de Telnyx es única en esta lista: al ubicar la inferencia de GPU (STT, LLM, TTS) en los mismos puntos de presencia globales que su infraestructura de telefonía de nivel de operador, Telnyx elimina los saltos de API entre servicios que causan la acumulación de latencia en configuraciones de múltiples proveedores.
La implicación en producción: latencia de extremo a extremo inferior a 200 ms en producción, la más rápida de esta lista. La consistencia de la P99 bajo carga concurrente también es la más sólida, porque los saltos de red entre los componentes de procesamiento se miden en microsegundos (mismo centro de datos) en lugar de milisegundos (llamadas API entre regiones).
Lo que dicen los usuarios de G2 (4.3/5):
Los usuarios de G2 elogian constantemente la confiabilidad de la infraestructura y la consistencia de la latencia de Telnyx como la principal ventaja para el desarrollador, específicamente la eliminación de los picos de latencia que ocurren cuando los datos deben viajar entre proveedores externos de STT, LLM, TTS y telefonía en regiones separadas.
Precios: Desde $0.07/minuto con descuentos por volumen. Personalizado para empresas. Requiere un desarrollador o integrador de sistemas para una configuración completa.
Características específicas para desarrolladores:
Inferencia de GPU y telefonía ubicadas en el mismo lugar: elimina la acumulación de latencia entre API
Latencia de extremo a extremo inferior a 200 ms en producción
Control total de todo el stack (STT, LLM, TTS y telefonía en una sola plataforma)
Cobertura global de PSTN en más de 180 países
Soporte para BYOC y BYOL
SLA de tiempo de actividad del 99.999% de nivel de operador
Pros:
Latencia de producción inferior a 200 ms: la más rápida de esta lista.
Elimina la acumulación de latencia a nivel de infraestructura.
SLA de tiempo de actividad de 99.999%.
Cobertura global de nivel de operador.
Todo el stack en una sola plataforma.
Contras:
Requiere conocimientos de ingeniería: no es adecuado para equipos no técnicos.
Calificación de G2 (4.3) inferior a la de Retell (4.8).
Complejidad de configuración elevada.
Una comunidad de desarrolladores menos madura que la de Vapi.
Lo que la hace única: Telefonía e inferencia de IA ubicadas en el mismo lugar: la única plataforma que elimina la latencia entre API a nivel de infraestructura, ofreciendo un rendimiento en producción inferior a 200 ms que los stacks de múltiples proveedores no pueden igualar.
7. LiveKit — El mejor para medios en tiempo real + marco de agentes de voz
Calificación G2: Aún no es significativa: plataforma en fase inicial
Ideal para: Equipos de desarrolladores que crean aplicaciones de medios en tiempo real (videollamadas, transmisiones de audio, WebRTC) que desean añadir funciones de agentes de voz con IA a una infraestructura de medios en tiempo real ya existente.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente un día. La infraestructura de código abierto en tiempo real de LiveKit maneja WebRTC, SFU y el enrutamiento de audio/video, y el marco de Agents añade capacidades de voz de IA sobre esto. Para los equipos que ya utilizan LiveKit para medios en tiempo real, añadir IA de voz no requiere reemplazar la capa de medios.
La ventaja específica para desarrolladores: LiveKit es de código abierto y autoalojable. Los equipos con requisitos de residencia de datos (salud, finanzas, gobierno) pueden implementar todo el stack en su propia infraestructura. Los SDK de Agents para Python/JavaScript/Go proporcionan interfaces con tipos para construir agentes de voz que se integran directamente con la arquitectura de salas en tiempo real de LiveKit.
Precios: Gratis para autoalojado. Planes en la nube desde $0.002/minuto. Personalizado para empresas.
Características específicas para desarrolladores:
De código abierto y autoalojable
Marco de Agents para IA de voz con SDK con tipos para Python/JS/Go
WebRTC + SFU para medios en tiempo real junto con agentes de voz
Trae tu propio STT, LLM, TTS
Servidor de tuberías: cadenas de procesamiento de audio de múltiples pasos
Cumplimiento autoalojado: control total de la residencia de datos
Pros:
De código abierto y autoalojable: cero dependencia de un proveedor.
El mejor para equipos que necesitan un control total de la infraestructura.
El marco de Agents proporciona abstracciones limpias para la IA de voz.
Comunidad de desarrolladores activa.
Servidor de tuberías para procesamiento de audio complejo.
Contras:
Requiere recursos de ingeniería para autoalojar y mantener.
No hay soporte de producción gestionado sin un plan empresarial.
Herramientas de voz de IA menos maduras que Retell o Vapi para casos de uso puros de agentes telefónicos.
Lo que la hace única: El único marco de agentes de voz y medios en tiempo real totalmente de código abierto: los equipos con preocupaciones estrictas sobre la residencia de datos, el cumplimiento o la dependencia de proveedores pueden autoalojar el stack completo sin dependencias externas.
8. AssemblyAI — El mejor ASR para confiabilidad en producción centrada en desarrolladores
Calificación G2: 4.8/5
Ideal para: Equipos de desarrolladores que necesitan un ASR confiable en producción con funciones de inteligencia de voz (diarización de interlocutores, análisis de sentimiento y moderación de contenido) integradas sin configuración adicional.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente 30 minutos. La experiencia de desarrollo de AssemblyAI es la más consistente en todas nuestras pruebas: la documentación de la API es de nivel de producción (no solo ejemplos de inicio rápido), los mensajes de error son procesables y la API de WebSocket de transmisión maneja el audio en tiempo real de manera limpia.
El diferenciador específico para desarrolladores frente a Deepgram: AssemblyAI incluye funciones de inteligencia de voz (diarización de interlocutores, análisis de sentimiento, detección de entidades, seguridad de contenido) como endpoints de API de primera clase en lugar de complementos separados. Para stacks de agentes de voz donde el análisis de llamadas es tan importante como la conversación del agente, esta integración reduce el número de pasos de procesamiento posterior requeridos.
Lo que dicen los usuarios de G2 (4.8/5):
"AssemblyAI ha construido una sólida reputación como una plataforma de IA de voz centrada en la API, con un enfoque en la experiencia del desarrollador y la confiabilidad en producción. La transcripción por transmisión es sólida y la documentación se mantiene firme en producción, no solo en tutoriales de inicio rápido." — Contexto de reseña de G2 (desarrollador profesional)
Precios: Transcripción por transmisión a $0.0043/minuto. $0.000025/token para LeMUR (funciones de LLM). Nivel gratuito generoso. Personalizado para empresas.
Características específicas para desarrolladores:
Streaming ASR con inteligencia de voz integrada
Diarización de interlocutores estándar (no como complemento)
Análisis de sentimiento, detección de entidades y seguridad de contenido a través de API
LeMUR: comprensión de audio impulsada por LLM (resumir, hacer preguntas sobre el audio)
Cumple con SOC 2 Tipo II
Transmisión en tiempo real y por lotes asíncronos desde una sola API
Pros:
4.8/5 G2: empatado con el ASR mejor valorado de esta lista.
Inteligencia de voz integrada (diarización, sentimiento, entidades).
Experiencia de desarrollo y documentación limpias.
Transmisión confiable en producción.
Cumple con SOC 2.
Contras:
Solo capa de ASR: requiere un stack de orquestación completo para el despliegue del agente de voz.
Costo por minuto ligeramente superior al de Deepgram.
Sin TTS ni telefonía.
Lo que la hace única: ASR con inteligencia de voz integrada: la única capa de ASR que proporciona identificación de interlocutores, análisis de sentimiento y extracción de entidades en la misma llamada de API que la transcripción, reduciendo la complejidad del stack de procesamiento posterior.
9. Cartesia — El mejor TTS de baja latencia para stacks de voz de desarrolladores
Calificación G2: Aún no es significativa: plataforma más reciente
Ideal para: Equipos de desarrolladores que optimizan la calidad de la voz y la latencia del TTS en la capa de síntesis, especialmente para casos de uso de agentes de voz donde una latencia de TTS de 90 ms frente a 500 ms marca la diferencia entre una conversación natural y una robótica.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente 30 minutos. El modelo Sonic-3 de Cartesia logra un tiempo hasta el primer audio de 90 ms, el TTS más rápido que medimos. Para los stacks de agentes de voz donde el TTS suele ser el componente más lento, esta ventaja de latencia se percibe directamente en la naturalidad de la conversación.
La clonación de voz a partir de 3 segundos de audio es el umbral más bajo de esta lista, lo que permite la creación rápida de personalidades de voz para agentes de voz de IA específicos de la marca. La API de transmisión por WebSocket permite la generación de audio en tiempo real para conversaciones telefónicas en vivo.
Precios: Básico desde $4/mes; API de pago por uso. Personalizado para empresas. El uso comercial está restringido en el plan gratuito.
Características específicas para desarrolladores:
Tiempo hasta el primer audio de 90 ms: el TTS más rápido probado
Clonación de voz a partir de 3 segundos de audio
Transmisión por WebSocket para síntesis en tiempo real
Más de 30 idiomas
API limpia para desarrolladores con SDK para Python/TypeScript
Plataforma de agentes de voz dedicada (Line) para aplicaciones de transmisión por WebSocket
Pros:
La latencia de TTS más rápida probada (90 ms).
Clonación de voz en 3 segundos.
Transmisión por WebSocket.
Experiencia de desarrollo limpia.
El precio de suscripción más bajo de esta lista.
Contras:
Solo capa de TTS: requiere un stack de orquestación completo.
El uso comercial está restringido en el plan gratuito.
Biblioteca de idiomas más pequeña que la de ElevenLabs.
Plataforma más reciente con una comunidad de desarrolladores más pequeña.
Lo que la hace única: Síntesis de TTS de 90 ms: cuando el flujo de conversación del agente de voz combina la calidad de voz de ElevenLabs a la velocidad de Cartesia, el resultado es la mejor relación entre naturalidad y latencia disponible en cualquier stack de TTS para desarrolladores.
10. Voiceflow — El mejor diseño visual de conversaciones para desarrolladores
Calificación G2: 4.7/5
Ideal para: Equipos de desarrolladores que desean diseñar, prototipar y probar flujos de conversación complejos de forma visual antes de escribir código de producción, particularmente para conversaciones ramificadas de múltiples intenciones donde el mapeo del estado es la parte difícil.
Nuestra experiencia de prueba:
La configuración tomó aproximadamente dos días para el diseño de conversación completo y el despliegue en producción. El creador visual de máquinas de estado de Voiceflow es el entorno de diseño de conversaciones más maduro de esta lista: cada intención, ruta, respaldo y acción de cumplimiento se define explícitamente en un gráfico de nodos antes del despliegue.
La ventaja específica para desarrolladores: el diseño visual de conversaciones detecta casos límite antes de la producción. Un registro de siniestros complejo, una calificación de clientes potenciales de múltiples pasos o un flujo de citas médicas con más de 30 rutas posibles es mucho más fácil de validar de forma visual que a través del código. Voiceflow exporta luego la lógica de conversación a código, o la implementa a través de API en Retell, Twilio o telefonía personalizada.
Lo que dicen los usuarios de G2 (4.7/5):
"La capacidad de prototipar y probar flujos conversacionales rápidamente se destacó, especialmente para los equipos que refinan los recorridos de los usuarios antes del despliegue. El entorno de diseño visual detecta ambigüedades que nunca habríamos encontrado en el código hasta que estuvieran en vivo." — Reseña de G2, Voiceflow
Precios: Gratis (2 agentes); Pro desde $50/mes/editor; Team desde $125/mes; Personalizado para empresas.
Características específicas para desarrolladores:
Creador visual de conversaciones con máquina de estados
Exporte la lógica de conversación a código o impleméntela a través de API
Despliegue multicanal (voz, chat, SMS) desde un solo diseño
Arquitectura centrada en la API para actualizaciones programáticas de agentes
Integración con Retell, Twilio y telefonía personalizada
Más de 100 integraciones prediseñadas
Pros:
El mejor entorno de diseño visual de conversaciones.
El modelo de máquina de estados detecta casos límite en la preproducción.
Multicanal desde un solo diseño.
Centrado en la API para actualizaciones programáticas.
4.7/5 G2 de una base de reseñas significativa.
Contras:
El despliegue de voz requiere telefonía externa (Retell, Twilio), no es independiente.
La ejecución de voz en producción es menos madura que en plataformas de voz puras.
Algunos usuarios reportan la necesidad de infraestructura adicional para despliegues complejos en tiempo real.
Lo que la hace única: Arquitectura visual de conversación antes del código: la única herramienta para desarrolladores que hace práctico diseñar y validar visualmente flujos de conversación ramificados complejos, detectando fallas de producción antes de que lleguen a los usuarios.
El marco de decisión para desarrolladores: ¿Qué capa necesita?
¿Desea lanzar un agente de voz en funcionamiento esta semana sin construir infraestructura?
Retell AI (configuración en 45 minutos, listo para producción, BYOL/BYOC). Brilo.ai (configuración en 7 minutos, integrado con API, plataforma completa). Ambos eliminan las 400 horas de ingeniería del desarrollo de orquestación.
¿Necesita la máxima flexibilidad de componentes y está dispuesto a asumir la complejidad de la orquestación?
Vapi.ai: traiga su propio STT, LLM, TTS; comunidad de más de 500,000 desarrolladores; sea dueño de cada componente de manera independiente.
¿Necesita la mejor base de ASR para su propio stack de voz?
Deepgram Nova-3 para audio de telefonía robusto contra el ruido. AssemblyAI para confiabilidad en producción con inteligencia de voz integrada.
¿Necesita la mejor calidad de voz y la síntesis de TTS más rápida?
ElevenLabs Flash v2.5 para síntesis en menos de 100 ms y una naturalidad de referencia en la industria. Cartesia Sonic-3 para TTS de 90 ms a un precio más bajo.
¿Necesita un control total de la infraestructura con telefonía e IA ubicadas en el mismo lugar?
Telnyx: latencia de producción inferior a 200 ms, sin saltos de API intermedios, confiabilidad de nivel de operador.
¿Está construyendo sobre código abierto o autoalojando por motivos de cumplimiento?
Marco LiveKit Agents: totalmente de código abierto, autoalojable, sin dependencia de proveedores.
¿Necesita diseñar flujos de conversación complejos visualmente antes de escribir código?
Voiceflow: creador visual con máquina de estados y luego despliegue en Retell o Twilio.
El modelo de costo real que todo desarrollador debería ejecutar
Antes de comprometerse con cualquier plataforma, modele el costo real total según su volumen de producción proyectado. La tarifa por minuto anunciada casi nunca coincide con el costo real de producción:
Ejemplo: 10,000 llamadas/mes, promedio de 3 minutos, usando Vapi con proveedores externos:
Orquestación de Vapi: $0.05 × 30,000 min = $1,500
Deepgram Nova-3 STT: $0.0043 × 30,000 min = $129
LLM GPT-4o: ~$0.10 × 30,000 min = $3,000 (depende en gran medida del número de turnos)
TTS de ElevenLabs: ~$0.03 × 30,000 min = $900
Telefonía de Twilio: ~$0.013 × 30,000 min = $390
Total: ~$5,919/mes frente a los $0.05/minuto anunciados
Mismo volumen en Retell AI:
Retell total integrado: $0.07 × 30,000 min = $2,100
Telefonía de Twilio: ~$0.013 × 30,000 min = $390
Total: ~$2,490/mes
El costo de ingeniería de construir y mantener el stack de Vapi frente al uso de la orquestación integrada de Retell es adicional; por lo general, representa más de 400 horas de trabajo de desarrolladores senior.
Preguntas frecuentes
¿Cuál es la diferencia entre una plataforma de IA de voz y una API de IA de voz?
Una API de IA de voz proporciona un componente de la pila — Deepgram para ASR, ElevenLabs para TTS, o OpenAI para LLM. Una plataforma de IA de voz orquesta múltiples componentes en un agente de voz desplegable, gestionando la alternancia de turnos, la interrupción del usuario (barge-in), la telefonía y la lógica de la conversación. La mayoría de los desarrolladores comienzan con APIs y descubren que necesitan una plataforma.
¿Qué es el traer tu propio modelo (BYOM, por sus siglas en inglés) y por qué es importante para los desarrolladores?
BYOM (Trae tu propio modelo) significa que puedes intercambiar los componentes de IA (LLM, STT, TTS) en la pila de tu agente de voz de forma independiente. Sin BYOM, quedas limitado a los modelos predeterminados de la plataforma, que podrían no ser la mejor opción para tu caso de uso, idioma o requisitos de cumplimiento. Tanto Vapi como Retell ofrecen BYOM completo. Brilo.ai ofrece opciones de ASR configurables.
¿Cuál es el tiempo de puesta en producción oficial más rápido para las plataformas de voz para desarrolladores?
Brilo.ai: 7 minutos (plataforma integrada, sin código). Deepgram/AssemblyAI: ~30 minutos (solo ASR). Retell AI: ~45 minutos (agente completo). Vapi: ~1 día completo de desarrollador (con configuración de proveedor externo). Telnyx: 1–2 días (configuración de infraestructura). LiveKit autoalojado: de días a semanas (despliegue completo de infraestructura).
¿Qué es la acumulación de latencia y cómo la evitan los desarrolladores?
La acumulación de latencia es el retraso acumulado al encadenar múltiples llamadas de API externas (STT → LLM → TTS → telefonía), donde cada salto añade entre 50 y 150 ms. En momentos de carga máxima, una pila de 4 proveedores puede alcanzar los 1,400 ms en P99. Soluciones: utilizar una plataforma con orquestación integrada (Retell, Brilo.ai), usar infraestructura co-ubicada (Telnyx) o implementar los componentes en la misma región de la nube.
¿Qué plataforma de voz de IA tiene la comunidad de desarrolladores más grande?
Vapi es el más grande con más de 500,000 desarrolladores registrados. Deepgram tiene más de 200,000 desarrolladores que utilizan sus APIs. Retell cuenta con más de 3,000 empresas en producción con más de 30 millones de llamadas al mes. ElevenLabs tiene una gran comunidad de desarrolladores creativos, pero menos profesionales en agentes de voz.
¿Qué certificaciones de cumplimiento de normativa deberían tener las plataformas de voz para desarrolladores?
Para el sector salud: HIPAA (autoservicio, no solo para empresas). Para servicios financieros: SOC 2 Tipo II. Para despliegues en la UE: GDPR. Para el procesamiento de pagos: PCI DSS. Retell AI, Deepgram, AssemblyAI y Telnyx ofrecen autoservicio compatible con SOC 2 e HIPAA. Cognigy ofrece despliegue local (on-premise) para los requisitos de residencia de datos más estrictos.
¿Cuál es el gasto mínimo para el desarrollo de IA de voz en producción?
Brilo.ai: $0 (plan gratuito, 10 minutos/mes). Deepgram: $0 ($200 en créditos gratuitos). Retell AI: $0 ($10 en créditos gratuitos, ~60 minutos). Vapi: $0 ($10 en créditos gratuitos). ElevenLabs: $5/mes. Cartesia: $4/mes. La mayoría de las plataformas permiten realizar pruebas reales antes de cualquier suscripción.
El resultado final
El mercado de plataformas de voz de IA para desarrolladores ha madurado en 2026, pero aún es fácil elegir la capa incorrecta, construir una infraestructura que una plataforma ya habría proporcionado o descubrir problemas de latencia en producción que los entornos de demostración ocultaban. Los equipos que realizan lanzamientos más rápido y gastan menos son aquellos que identifican correctamente qué capa necesitan poseer y qué capas deberían comprar.
Las mejores plataformas de voz de IA para desarrolladores según el caso de uso:
Tiempo más rápido para producción: Brilo.ai (7 min, plataforma completa integrada por API)
Mejor plataforma general para desarrolladores: Retell AI (4.8/5 G2, BYOL/BYOC, configuración en 45 min)
Máxima flexibilidad de componentes: Vapi.ai (más de 500k desarrolladores, BYOK completo)
Mejor base de ASR (robusta al ruido): Deepgram Nova-3
Mejor calidad de voz + síntesis TTS: ElevenLabs Flash v2.5
Mejor control de infraestructura: Telnyx (menos de 200 ms, coubicada)
Código abierto + autohospedado: LiveKit Agents
Mejor ASR + inteligencia de voz: AssemblyAI
Síntesis TTS más rápida: Cartesia Sonic-3 (90 ms)
Mejor herramienta de diseño conversacional: Voiceflow
Últimas novedades
Todos los recursos
Artículos
Casos de estudio
Tutoriales

Artículos
Servicio de atención de llamadas médicas de Wisconsin: cuando quien llama no es el paciente
¿Está comparando servicios de contestador médico en Wisconsin? Póngalos a prueba con llamadas de familiares y cuidadores: HIPAA, el Estatuto de Wisconsin 146.82, representantes de atención médica y qué decir.

Artículos
Servicios de contestador médico en Carolina del Sur: La llamada del nuevo paciente
¿Está comparando los servicios de atención telefónica para médicos en Carolina del Sur? Descubra cómo gestiona cada uno las llamadas de pacientes nuevos: seguros, presupuestos para pagos por cuenta propia y transferencia de historiales médicos.
Cargar más
Últimas novedades
Todos los recursos
Artículos
Casos de estudio
Tutoriales
Artículos
Servicio de atención de llamadas médicas de Wisconsin: cuando quien llama no es el paciente
¿Está comparando servicios de contestador médico en Wisconsin? Póngalos a prueba con llamadas de familiares y cuidadores: HIPAA, el Estatuto de Wisconsin 146.82, representantes de atención médica y qué decir.
Artículos
Servicios de contestador médico en Carolina del Sur: La llamada del nuevo paciente
¿Está comparando los servicios de atención telefónica para médicos en Carolina del Sur? Descubra cómo gestiona cada uno las llamadas de pacientes nuevos: seguros, presupuestos para pagos por cuenta propia y transferencia de historiales médicos.
Cargar más
Automatice su negocio con agentes telefónicos de IA
Automatice su negocio con agentes telefónicos de IA
Automatice su negocio con agentes telefónicos de IA
Automatice su negocio con agentes telefónicos de IA
Automatización de llamadas para el sector salud, inmobiliario, logística, servicios financieros y pequeñas empresas.
Automatización de llamadas para el sector salud, inmobiliario, logística, servicios financieros y pequeñas empresas.
Unirse a Discord
Conéctese con nuestra comunidad, haga preguntas y manténgase al día con las novedades del producto.
Reservar una llamada
Programe una llamada rápida con nuestro equipo para explorar soluciones para sus necesidades.
Empezar
Industrias
Casos de uso
Integraciones
Legal y Comunidad
Unirse a Discord
Conéctese con nuestra comunidad, haga preguntas y manténgase al día con las novedades del producto.
Reservar una llamada
Programe una llamada rápida con nuestro equipo para explorar soluciones para sus necesidades.
Empezar
Industrias
Casos de uso
Integraciones
Legal y Comunidad
Unirse a Discord
Conéctese con nuestra comunidad, haga preguntas y manténgase al día con las novedades del producto.
Reservar una llamada
Programe una llamada rápida con nuestro equipo para explorar soluciones para sus necesidades.
Empezar
Industrias
Casos de uso
Integraciones
Legal y Comunidad
Unirse a Discord
Conéctese con nuestra comunidad, haga preguntas y manténgase al día con las novedades del producto.
Reservar una llamada
Programe una llamada rápida con nuestro equipo para explorar soluciones para sus necesidades.
Empezar
Industrias
Casos de uso
Integraciones
Legal y Comunidad